
本文概略介紹 Fuchsia 介面定義語言 (FIDL),這種語言用於描述 Fuchsia 執行程式所用的處理序間通訊 (IPC) 通訊協定。本總覽介紹 FIDL 背後的概念,熟悉這些概念的開發人員可以按照教學課程開始編寫程式碼,或閱讀語言或繫結參考資料,深入瞭解相關資訊。
什麼是 FIDL?
雖然「FIDL」代表「Fuchsia 介面定義語言」,但這個字詞本身可用於指稱多個不同概念:
- FIDL 傳輸格式:FIDL 傳輸格式會指定 FIDL 訊息在記憶體中的表示方式,以便透過 IPC 傳輸
- FIDL 語言:FIDL 語言是用於描述
.fidl檔案中通訊協定的語法 - FIDL 編譯器:FIDL 編譯器會產生程式碼,供程式使用及實作通訊協定
- FIDL 繫結:FIDL 繫結是特定語言的執行階段支援程式庫和程式碼產生器,提供用於操控 FIDL 資料結構和通訊協定的 API。
FIDL 的主要工作是讓不同的用戶端和服務互通。將 IPC 機制的實作與其定義分離,有助於用戶端多樣性,並透過自動產生程式碼簡化。
FIDL 語言提供類似 C 的熟悉 (但簡化) 宣告語法,可讓服務供應商精確定義其通訊協定。基本資料類型 (例如整數、浮點數和字串) 可以組合成更複雜的匯總結構和聯集。固定陣列和動態大小向量可以從基本類型和匯總類型建構,而且這些類型都可以組合成更複雜的資料結構。
由於用戶端實作目標語言 (C、C++、Rust、Dart 等) 數量眾多,我們不希望服務開發人員必須為每個語言提供通訊協定實作。
這時 FIDL 工具鍊就能派上用場。服務開發人員只需建立一個 .fidl 定義檔案,用於定義通訊協定。FIDL 編譯器會使用這個檔案,以任何支援的譯文語言產生用戶端和伺服器程式碼。
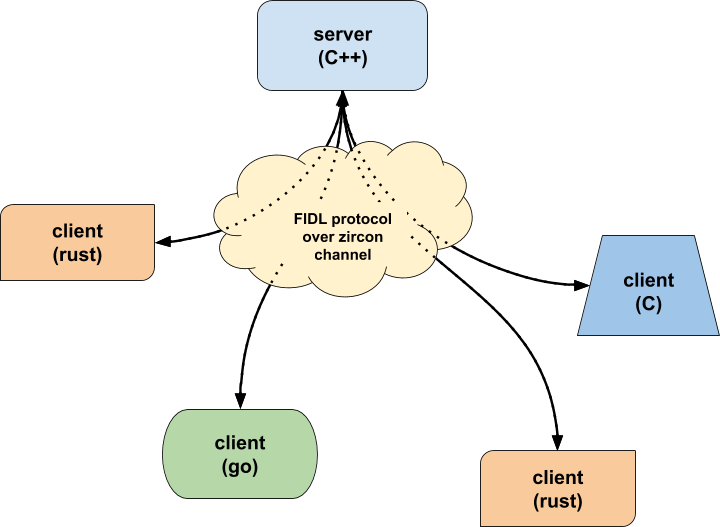
在許多情況下,伺服器只會有一種實作方式 (例如,特定服務可能以 C++ 實作),而用戶端則可能有多種實作方式,並以多種語言編寫。
請注意,Fuchsia 作業系統本身並不瞭解 FIDL。FIDL 繫結在 Fuchsia 中使用標準管道通訊機制。FIDL 繫結和程式庫會針對該管道的使用方式,強制執行一組語意行為和持續性格式。
FIDL 架構
從開發人員的角度來看,主要元件如下:
- FIDL 定義檔案:這是一個文字檔案 (依照慣例以
.fidl結尾),用於定義值和通訊協定 (方法及其參數), - 用戶端程式碼:由 FIDL 編譯器 (
fidlc) 工具鍊為每個特定目標語言產生,以及 - 伺服器程式碼,同樣由 FIDL 編譯器工具鍊產生。
以「echo」服務為例,說明 FIDL 定義檔案的簡單範例:無論用戶端傳送什麼內容給伺服器,伺服器都會回傳給用戶端。
為求明確,我們加上了行號,但這並非
.fidl檔案的一部分。
1   library fidl.examples.echo;
2
3   @discoverable
4   protocol Echo {
5       EchoString(struct {
6           value string:optional;
7       }) -> (struct {
8           response string:optional;
9       });
10  };
我們逐行說明。
第 1 行:library 關鍵字用於定義這個通訊協定的命名空間。不同程式庫中的 FIDL 通訊協定可能具有相同名稱,因此命名空間可用於區分這些通訊協定。
第 3 行:@discoverable 屬性表示應提供後續通訊協定,供用戶端連線。
第 4 行:protocol 關鍵字會引入通訊協定的名稱,這裡稱為 Echo。
第 5 至 9 行:方法、參數和傳回值。這行程式碼有兩個不尋常之處:
- 請注意
string:optional宣告 (適用於value和response)。string部分表示參數是字串 (字元序列),而optional限制則表示參數為選用。 - 參數會包裝在
struct中,這是包含方法參數的頂層類型。 ->部分表示傳回值,會顯示在方法宣告之後,而非之前。與 C++ 或 Java 不同,方法可以傳回多個值。
上述 FIDL 檔案宣告了一個名為 Echo 的通訊協定,其中包含一個名為 EchoString 的方法,該方法會接受可為空值的字串,並傳回可為空值的字串。
上述簡單範例只使用一種資料類型,即 string,做為方法的輸入和輸出。
可能的 FIDL 資料類型非常靈活:
type MyRequest = struct {
    serial uint32;
    key string;
    options vector<uint32>;
};
上述程式碼宣告名為 MyRequest 的結構,其中包含三個成員:名為 serial 的不帶正負號 32 位元整數、名為 key 的字串,以及名為 options 的不帶正負號 32 位元整數向量
訊息模型
為了瞭解 FIDL 的訊息傳遞,我們需要將其分為兩個層級,並釐清一些定義。
在底部 (作業系統層),有一個非同步通訊配置,專為傳送者和接收者的獨立進度而設計:
- 寄件者:傳送訊息的一方
- 接收者:接收訊息的一方
傳送訊息是非阻塞作業:傳送者傳送訊息後,無論接收者正在做什麼,都可以自由繼續處理。
接收端可以視需要封鎖,等待訊息。
頂層會實作 FIDL 訊息,並使用底層 (非同步)。它會處理用戶端和伺服器:
- 用戶端:向伺服器提出要求的一方。
- 伺服器:代表用戶端處理要求的對象。
在討論訊息本身時,「傳送者」和「接收者」這兩個詞彙很有意義,因為基礎通訊配置不關心我們指派給各方的角色,只關心一方傳送,另一方接收。
在討論各方扮演的角色時,「用戶端」和「伺服器」這兩個詞彙很有意義。具體來說,用戶端可以在某個時間點擔任傳送者,並在另一個時間點擔任接收者;伺服器也是如此。
實際上,在用戶端/伺服器互動的情境中,這代表有幾種模型:
- 封鎖呼叫:用戶端傳送至伺服器,等待回覆
- fire and forget:用戶端傳送至伺服器,不預期回覆
- 回呼或非同步呼叫:用戶端傳送至伺服器,但不會封鎖;回覆會在稍後以非同步方式傳送
- event:伺服器傳送至用戶端,用戶端未要求資料
第一個是同步,其餘是非同步。我們將依序討論這些內容。
用戶端傳送至伺服器,等待回覆
這個模型是大多數程式設計語言中可用的傳統「封鎖呼叫」或「函式呼叫」,但叫用是透過管道完成,因此可能會因傳輸層級錯誤而失敗。
從用戶端的角度來看,這包含一個會封鎖的呼叫,而伺服器會執行一些處理。
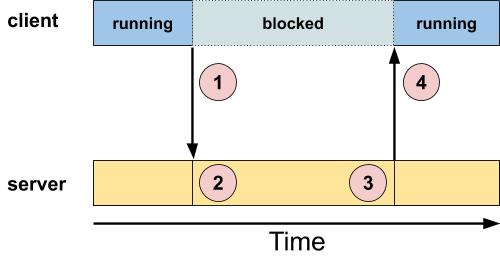
以下是逐步說明:
- 用戶端發出呼叫 (可選擇是否包含資料) 並封鎖。
- 伺服器收到用戶端的呼叫 (和選用資料),並執行一些處理作業。
- 伺服器會自行決定是否回覆用戶端 (可選擇是否提供資料)。
- 伺服器的回覆會解除用戶端的封鎖。
透過非同步訊息傳遞配置實作這種同步訊息傳遞模型很簡單。請注意,在通訊協定的底層,用戶端到伺服器和伺服器到用戶端的訊息傳輸都是非同步的。同步處理會在用戶端進行,用戶端會封鎖,直到伺服器的訊息送達為止。
基本上,在這個模型中,用戶端和伺服器已達成協議:
- 資料流由用戶端發起
- 用戶端最多只能有一則未完成的訊息,
- 伺服器只能在回應用戶端訊息時,傳送訊息給用戶端
- 用戶端應等待伺服器回應,再繼續操作。
這種封鎖模型通常用於用戶端需要先取得目前要求的回覆,才能繼續執行的情況。
舉例來說,用戶端可能會向伺服器要求資料,但在資料送達前,無法執行任何其他有用的處理作業。
或者,用戶端可能需要按照特定順序執行步驟,因此必須確保每個步驟都完成後,再啟動下一個步驟。如果發生錯誤,用戶端可能需要根據作業進度採取修正措施,這也是與每個步驟完成同步處理的另一個原因。
用戶端傳送至伺服器,無回覆
這種模式也稱為「啟動即棄用」。用戶端會將訊息傳送至伺服器,然後繼續執行作業。與封鎖模式相反,用戶端「不會」封鎖,也「不會預期收到回應」。
如果用戶端不需要 (或無法) 同步處理要求,就會使用這個模型。
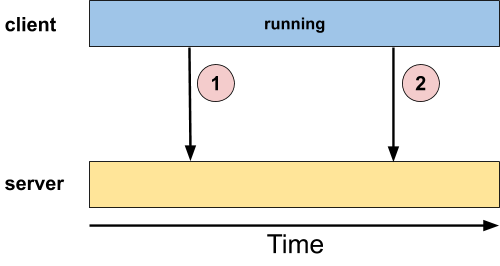
經典的例子就是記錄系統。用戶端會將記錄資訊傳送至記錄伺服器 (上圖中的圓圈「1」和「2」),但沒有理由封鎖。伺服器端可能會發生許多問題:
- 伺服器目前忙碌中,無法處理寫入要求。
- 媒體已滿,伺服器無法寫入資料。
- 伺服器發生錯誤
- 以此類推。
不過,用戶端無法對這些問題採取任何行動,因此封鎖只會造成更多問題。
用戶端傳送至伺服器,但不會封鎖
這個模型和下一個模型 (「伺服器傳送至用戶端,用戶端不要求資料」) 類似。
在目前的模型中,用戶端會傳送訊息給伺服器,但不會封鎖。不過,用戶端會預期伺服器傳回某種回應,但重點在於這與要求並非「同步」。
這讓用戶端/伺服器互動具有極大的彈性。
同步模型會強制用戶端等待伺服器回覆,而本模型則可讓用戶端在伺服器處理要求時執行其他操作:
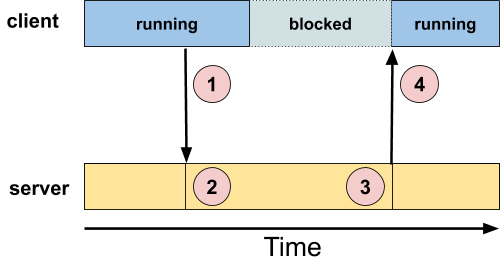
這張圖與上方的類似圖表有些微差異,在圓圈「1」之後,用戶端仍在執行。用戶端會選擇何時放棄 CPU,這與訊息不同步。
這裡實際上包含兩種子案例:一種是用戶端只會收到一個回應,另一種是用戶端可以收到多個回應。(用戶端未收到任何回應的模式,就是我們稍早討論過的「啟動後不須控制」模式)。
單一要求,單一回應
單一回應案例最接近同步模型:用戶端傳送訊息,伺服器最終會回覆。舉例來說,如果您知道用戶端在等待伺服器回覆時可以執行有用的工作,則可以使用此模型,而不是多執行緒。
單一要求,多個回應
多重回應案例可用於「訂閱」模式。用戶端的訊息會「預先通知」伺服器,例如在發生任何事件時要求通知。
接著,用戶端會繼續執行其業務。
一段時間後,伺服器注意到用戶端感興趣的條件已發生,因此會向用戶端傳送訊息。從用戶端/伺服器的角度來看,這則訊息是「回覆」,用戶端會以非同步方式接收這則訊息。
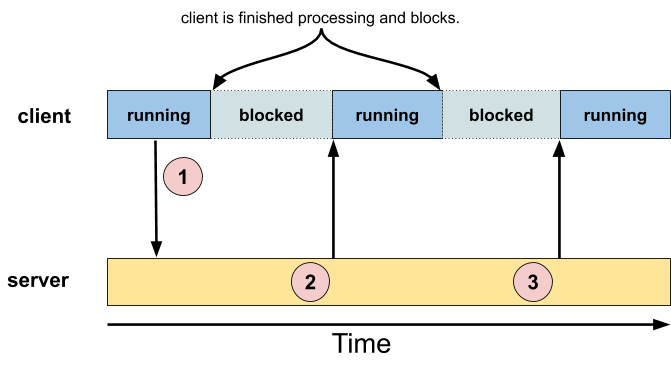
當其他感興趣的事件發生時,伺服器沒有理由不能傳送其他訊息;這是模型的「多重回應」版本。請注意,第二次 (和後續) 回應是在用戶端未傳送任何其他訊息的情況下傳送。
請注意,用戶端不需等待伺服器傳送訊息。在上圖中,我們在圓圈「3」之前顯示處於封鎖狀態的用戶端,用戶端也可能正在執行。
伺服器傳送至用戶端,用戶端不要求資料
這個模型也稱為「事件」模型。
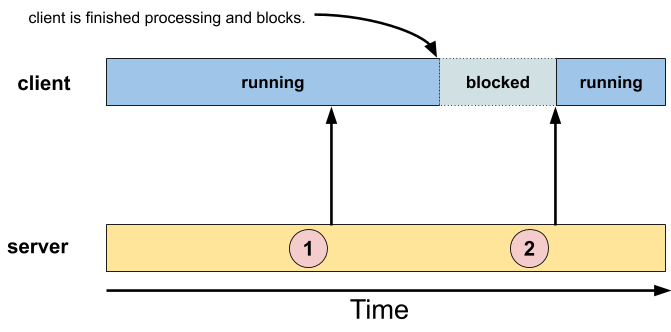
在這種模式中,用戶端準備接收來自伺服器的訊息,但不知道何時會收到。這些訊息不僅與用戶端非同步,而且 (從用戶端/伺服器的角度來看) 也是「未經請求」的,因為用戶端並未明確要求這些訊息 (如上述前一個模式)。
用戶端會指定一個函式 (「事件處理函式」),在伺服器傳送訊息時呼叫,但其他時候會繼續執行其業務。
伺服器會自行決定 (上圖中的圓圈「1」和「2」) 以非同步方式將訊息傳送至用戶端,並由用戶端指定的函式處理。
請注意,傳送訊息時,用戶端可能已經在執行 (如圓圈「1」所示),或者用戶端可能沒有任何工作,正在等待傳送訊息 (如圓圈「2」所示)。
用戶端不一定要等待訊息。
非同步訊息傳遞的複雜度
將非同步訊息傳遞拆分為上述 (有些武斷) 類別,是為了呈現一般使用模式,但並非詳盡無遺。
在最常見的非同步訊息傳遞情況下,您會有零或多則用戶端訊息,與零或多則伺服器回覆鬆散關聯。這種「鬆散關聯」會增加設計程序的複雜度。
FIDL 中的 IPC 模型
我們已瞭解 IPC 模型,以及這些模型如何與 FIDL 的非同步訊息互動,接著來看看這些模型的定義。
我們會將其他模型 (fire and forget、非同步呼叫或事件) 新增至通訊協定定義檔案:
1   library fidl.examples.echo;
2
3   @discoverable
4   protocol Echo {
5       EchoString(struct {
6           value string:optional;
7       }) -> (struct {
8           response string:optional;
9       });
10
11      SendString(struct { value string:optional; });
12
13      ->ReceiveString(struct { response string:optional; });
14  };
第 5-9 行是我們在上方討論的 EchoString 方法,這是傳統的函式呼叫訊息,用戶端會使用選用字串呼叫 EchoString,然後封鎖,等待伺服器回覆另一個選用字串。
第 11 行是 SendString 方法。它沒有 -> 傳回宣告,因此會變成「fire and forget」模型 (僅傳送),因為我們已告知 FIDL 編譯器,這個特定方法沒有相關聯的傳回。
請注意,這裡的關鍵在於缺少傳回宣告,而非缺少傳回參數。在
SendString後面加上「-> ()」會改變宣告的意義,從宣告「發射後不理」樣式方法,變成宣告沒有任何傳回引數的函式呼叫樣式方法。
第 13 行是 ReceiveString 方法。這與先前的方法略有不同,第一部分沒有方法名稱,而是在 -> 運算子之後提供。這會告知 FIDL 編譯器,這是「非同步呼叫」或「事件」模型宣告。
FIDL 繫結
FIDL 工具鍊會接收 FIDL 通訊協定和類型定義 (如上例所示),並以可「使用」這些通訊協定的各個譯文語言生成程式碼。產生的程式碼稱為 FIDL 繫結,視語言而定,有各種形式:
- 原生繫結:專為裝置驅動程式和高處理量伺服器等高度敏感的情境設計,可利用就地存取,避免記憶體配置,但開發人員可能需要更瞭解通訊協定的限制。
- 慣用繫結:設計上更方便開發人員使用,可將資料從線路格式複製到更易於使用的資料類型 (例如堆積支援的字串或向量),但效率也相對較低。
繫結提供多種叫用通訊協定方法的方式,具體取決於語言:
- 傳送/接收:直接讀取或寫入訊息至管道,不含內建等待迴圈 (C)
- 回呼式:收到的訊息會以非同步方式,在事件迴圈 (C++、Dart) 中做為回呼調度
- 以通訊埠為基礎:收到的訊息會傳送至通訊埠或 Future (Rust)
- 同步呼叫:等待回覆並傳回 (C++、Rust)
繫結提供下列部分或所有主體作業:
- 編碼:將原生資料結構就地轉換為線路格式 (與驗證結合)
- 解碼:將傳輸格式資料就地轉換為原生資料結構 (與驗證結合)
- 複製/移至慣用形式:將原生資料結構的內容複製到慣用資料結構,並移動控點
- 複製/移至原生表單:將慣用資料結構的內容複製到原生資料結構,控制代碼會移動
- Clone:複製原生或慣用資料結構 (不含僅限移動類型)
- Call:叫用通訊協定方法
用戶端實作
無論目標語言為何,fidlc FIDL 編譯器都會產生具有下列基本結構的用戶端程式碼。
第一部分包含管理和背景處理,包括:
- 提供連線至伺服器的方法
- 啟動非同步 (「背景」) 訊息處理迴圈
- 非同步呼叫樣式和事件樣式方法 (如有) 會繫結至訊息迴圈
第二部分包含傳統函式呼叫或「fire and forget」樣式方法的實作,視目標語言而定。一般來說,這包括:
- 建立可呼叫的 API 和宣告
- 為每個 API 產生程式碼,將呼叫中的資料封送至適合傳輸至伺服器的 FIDL 格式緩衝區
- 產生程式碼,將資料傳輸至伺服器
- 如果是函式呼叫樣式的呼叫,則會生成程式碼來:
- 等待伺服器回應
- 從 FIDL 格式的緩衝區取消封送資料,以及
- 透過 API 函式傳回資料。
當然,確切步驟可能因語言實作方式而異,但基本架構大致如此。
伺服器實作
fidlc FIDL 編譯器也會為指定的譯文語言產生伺服器程式碼。與用戶端程式碼一樣,無論目標語言為何,這段程式碼都有共同的結構。程式碼:
- 建立用戶端可連線的物件,
- 啟動主要處理迴圈,執行下列操作:
- 等待訊息
- 呼叫實作函式來處理訊息
- 如果指定,則會向用戶端發出非同步回呼,以傳回輸出內容
在接下來的章節中,我們將詳細說明每種語言的用戶端和伺服器程式碼實作方式。
為什麼要使用 FIDL?
Fuchsia 廣泛依賴 IPC,因為大部分功能都是在核心以外的使用者空間中實作,包括裝置驅動程式等特殊權限元件。因此,IPC 機制必須有效率、具確定性、穩健且易於使用:
IPC 效率是指在程序之間生成、傳輸及使用訊息所需的運算負擔。IPC 會參與系統運作的所有層面,因此必須具備高效率。FIDL 編譯器必須產生緊湊的程式碼,避免過度間接或隱藏成本。在最重要的地方,它至少應該和手動編寫的程式碼一樣好。
IPC 確定性是指在已知資源範圍內執行交易的能力。IPC 將廣泛用於檔案系統等重要系統服務,這些服務會為許多用戶端提供服務,且必須以可預測的方式執行。FIDL 傳輸格式必須提供強大的靜態保證,例如確保結構大小和版面配置不變,進而減少動態記憶體配置或複雜驗證規則的需求。
IPC 穩定性是指必須將 IPC 視為作業系統 ABI 的重要部分。維持二進位檔穩定性至關重要。通訊協定演進機制必須謹慎設計,以免違反現有服務及其用戶端的不變量,尤其是在考量確定性需求時。FIDL 繫結必須執行有效、輕量且嚴格的驗證。
IPC 易用性是指 IPC 通訊協定是作業系統 API 的重要部分。為透過 IPC 存取服務提供良好的開發人員人體工學,FIDL 程式碼產生器可免除手動編寫 IPC 繫結的負擔。此外,FIDL 程式碼產生器可以產生不同的繫結,以符合不同對象和其慣用語的需求。
目標
FIDL 專為最佳化這些特性而設計。具體來說,FIDL 的設計旨在達成下列目標:
優先權
- 說明 Zircon 上 IPC 使用的資料結構和通訊協定。
- 針對處理序間通訊進行最佳化。雖然 FIDL 也用於保存至磁碟和網路傳輸,但其設計並未針對這些次要用途進行最佳化。
- 在同一裝置上執行的程序之間,透過 Zircon 管道有效率地傳輸由資料 (位元組) 和功能 (控制代碼) 組成的訊息。
- 專為有效使用 Zircon 原始物件而設計。雖然 FIDL 也用於其他平台 (例如透過 ffx),但其設計以 Fuchsia 為優先。
- 提供便利的 API,可用於建立、傳送、接收及使用訊息。
- 執行充分的驗證,以維持通訊協定不變量 (但僅限於此)。
睡眠效率
- 效率 (速度和記憶體) 與使用手動資料結構相同。
- 傳輸格式使用未壓縮的原生資料類型,採用小端序和正確對齊方式,支援就地存取訊息內容。
- 如果訊息大小是靜態已知或有界限,則不需要動態記憶體配置,即可產生或使用訊息。
- 使用僅限移動語意明確處理擁有權。
- 資料結構封裝順序為標準、明確,且具有最小邊框間距。
- 避免回補指標。
- 避免執行昂貴的驗證作業。
- 避免可能溢位的計算。
- 運用通訊協定要求的管道,進行非同步作業。
- 結構的大小固定,可變大小的資料會儲存在行外。
- 結構並非自我描述,FIDL 檔案會描述其內容。
- 結構沒有版本控制,但通訊協定可以透過新方法擴充,以便演進。
人體工學
- Fuchsia 團隊維護的程式設計語言繫結:
- C、新 C++、高階 C++ (舊)、Dart、Rust
- 請注意,我們日後可能會支援其他語言,例如:
- Java、JavaScript 等
- 繫結和產生的程式碼會根據預期應用程式,以原生或慣用形式提供。
- 使用編譯時間程式碼生成功能,最佳化訊息序列化、反序列化和驗證。
- FIDL 語法熟悉、易於存取,且與程式設計語言無關。
- FIDL 提供程式庫系統,可簡化部署作業,並方便其他開發人員使用。
- FIDL 會表示系統 API 所需的最常見資料類型,但不會提供所有程式設計語言提供的所有類型完整一對一對應。
工作流程
本節將回顧使用 FIDL 描述的 IPC 通訊協定作者、發布者和消費者的工作流程。
編寫 FIDL
FIDL 通訊協定的作者會建立一或多個 .fidl 檔案,描述資料結構、通訊協定和方法。
作者會將 FIDL 檔案分組為一或多個 FIDL 程式庫。每個程式庫都代表一組邏輯相關的功能,並有專屬的程式庫名稱。同一程式庫中的 FIDL 檔案會隱含存取同一程式庫中的所有其他宣告。在組成程式庫的 FIDL 檔案中,宣告順序並不重要。
一個程式庫的 FIDL 檔案可以匯入另一個 FIDL 模組,藉此存取另一個 FIDL 程式庫中的宣告。匯入其他 FIDL 程式庫後,即可使用其符號,進而建構衍生自這些符號的通訊協定。匯入的符號必須由程式庫名稱或別名限定,以免命名空間衝突。
發布 FIDL
FIDL 通訊協定的發布者負責向消費者提供 FIDL 程式庫。例如,作者可以在公開來源存放區中散布 FIDL 程式庫,或將其做為 SDK 的一部分發布。
消費者只需將 FIDL 編譯器指向包含程式庫 (及其依附元件) FIDL 檔案的目錄,即可為該程式庫產生程式碼。具體細節通常會由消費者的建構系統處理。
使用 FIDL
FIDL 通訊協定的使用者會使用 FIDL 編譯器,產生適合與語言執行階段專屬繫結搭配使用的程式碼。對於某些語言執行階段,使用者可以選擇幾種不同類型的生成程式碼,這些程式碼在傳輸格式層級都可互通,但在來源層級可能無法互通。
在 Fuchsia 世界建構環境中,每個程式庫的個別 FIDL 建構目標會自動為所有相關語言產生 FIDL 程式庫的程式碼。
在 Fuchsia SDK 環境中,從 FIDL 程式庫產生程式碼,會是編譯使用這些程式庫的應用程式時的一環。
開始使用
如要進一步瞭解如何使用 FIDL,請參閱「指南」一節,其中提供多份開發人員指南和教學課程,供您參考。如果您在 Fuchsia 上開發,並想瞭解如何使用現有 FIDL API 的繫結,請參閱 FIDL 繫結參考資料。最後,如要進一步瞭解 FIDL 或想貢獻內容,請參閱 FIDL 語言參考資料或貢獻文件。