
记录 Fuchsia 轨迹 (.fxt) 后,您可以使用 SQL 通过 Perfetto 的轨迹处理器引擎以编程方式查询和分析底层轨迹数据。虽然 Perfetto 界面提供交互式时间轴可视化效果,但 SQL 分析可实现自动异常检测、定量性能回归分析和批量指标聚合。
如需了解核心 PerfettoSQL 方言、查询语法和标准表的简介,请参阅官方 PerfettoSQL 使用入门和 Perfetto SQL 表文档。
本指南将介绍如何使用以下工具分析 Fuchsia 轨迹:
* 选择合适的轨迹分析工具
* 使用 fx perf-analyze 进行高级别性能初步诊断
* Fuchsia 轨迹架构和数据模型
* 常见的 Fuchsia PerfettoSQL 配方
* 跨工具和环境运行查询
选择合适的轨迹分析工具
Fuchsia 开发者可以通过三种主要方式查询和检查轨迹数据。选择最适合您工作流程的工具:
-
可视化探索和临时检查:以交互方式浏览时间轴轨道、检查切片详细信息、在浏览器中运行临时 SQL 查询,以及分享永久链接。
fx perf-analyze(推荐用于 Fuchsia)自动分类和脚本化分析:运行精选的诊断插件(
cpu、binder),生成结构化输出(markdown、json、text),并直接从宿主终端运行批量 SQL 查询。这是智能体互动和自动化工作流的首选界面。trace_processor_shell独立和非 Fuchsia 环境:PerfettoSQL 背后的底层引擎。在以下情况下使用:在 Fuchsia 源代码检出之外进行开发(此时
fx不可用);针对上游 Perfetto SDK 构建自定义 Python/C++ 自动化;或使用交互式终端 REPL。
使用 fx perf-analyze 进行高级别性能问题分诊
对于常见的分诊工作流程,您无需从头开始编写原始 SQL 查询。Fuchsia 提供 fx perf-analyze,这是一种主机端 CLI 工具,可将标准性能启发式方法封装到自动化分析插件中,并提供灵活的查询运行程序。
fx perf-analyze 支持本地 .fxt 文件以及 Perfetto 界面永久链接网址(自动下载并缓存轨迹)。
自动化分类插件 (fx perf-analyze analyze)
analyze 子命令可执行专门的诊断插件:
fx perf-analyze analyze --trace <TRACE_FILE_OR_URL> --plugin <PLUGIN_NAME>您可以选择格式化 Markdown 表格输出 (--format markdown)、结构化 JSON (--format json) 或以制表符分隔的文本 (--format text)。
1. CPU 利用率和空闲电源分流(cpu 插件)
cpu 插件会运行多维诊断套件,以审核系统活动、过度唤醒和电源阻塞器:
睡眠不安的线程(唤醒次数):识别具有高上下文切换/唤醒频率和短运行时的线程,从而找出导致 CPU 核心无法进入深度睡眠状态的定时器抖动或未合并的轮询循环。
每个核心的利用率和处理速率:评估由 DVFS 频率缩放计数器 (
Rate:CPU:N) 加权的内核工作周期(活跃非空闲时间百分比)。CPU 消耗量最高的线程(常见嫌疑对象):按累积 CPU 总运行时对线程进行排名。
异步执行器开销:衡量在 Fuchsia 异步 Future 轮询(
executor/fuchsia_async)中花费的时间。Binder IPC 分解:量化 Starnix/Android Binder IPC 事务的量和延迟时间。
挂起和唤醒租约跟踪:审核系统活动管理器 (SAG) 挂起尝试和阻止系统挂起的有效唤醒租约。
fx perf-analyze --format markdown analyze \
  --trace trace.fxt \
  --plugin cpu \
  --limit 10
2. Starnix Binder 和 IPC 瓶颈分析(binder 插件)
binder 插件可审核 IPC 交易延迟和调度瓶颈:
错过的唤醒:检测到调度延迟,其中线程处于可运行状态(
R状态),但在被调度到 CPU 之前等待了过长时间。Binder 事务延迟时间:衡量客户端调度、队列等待和服务器处理的端到端流程延迟时间。
fx perf-analyze --format markdown analyze \
  --trace trace.fxt \
  --plugin binder \
  --threshold-ms 10.0
使用 fx perf-analyze query 运行自定义查询和批量查询
如需通过命令行运行临时 SQL 查询,请执行以下操作:
fx perf-analyze --format markdown query \
  --trace trace.fxt \
  --sql "SELECT count(*) AS total_slices FROM slice"
如需在单个 Trace Processor 提取会话中执行多个查询(避免重复的轨迹解析开销),请使用 @filepath 传递 JSON 查询批次:
[
  {
    "name": "total_slices",
    "sql": "SELECT count(*) AS count FROM slice;"
  },
  {
    "name": "unique_threads",
    "sql": "SELECT count(DISTINCT utid) AS count FROM thread;"
  }
]
fx perf-analyze --format json query \
  --trace trace.fxt \
  --batch @queries.json
Fuchsia 轨迹架构和数据模型
当 Perfetto Trace Processor 接收 Fuchsia 轨迹 (.fxt) 时,它会将二进制记录解析为关系型 SQLite 表。如需完整的架构参考,请参阅 Perfetto SQL 表。
Fuchsia 轨迹特有的关键概念和 ID 关系包括:
单位:所有时间戳 (
ts) 和时长值 (dur) 都以整数纳秒为单位存储。将纳秒转换为毫秒,方法是将纳秒数除以1e6(例如,dur / 1e6 AS dur_ms)。进程和线程:
process.name:Fuchsia 用户空间进程通过其组件网址/清单名称(例如archivist.cm、netstack.cm、scenic.cm)或内核进程名称 (kernel) 进行标识。process.pid和thread.tid:匹配 Fuchsia 内核对象 ID (KOID)。upid和utid:由 Trace Processor 生成的唯一内部 ID,用于区分 PID/TID 回收中的进程和线程。
轨道和切片(联接层次结构):
切片与时间轴轨道相关联,而不是直接与线程相关联。
如需将
slice与其thread和process相关联,请通过thread_track进行联接:
FROM slice s
JOIN thread_track tt ON s.track_id = tt.id
JOIN thread t USING (utid)
JOIN process p USING (upid)
流程(跨进程 / 异步因果关系):
flow表用于映射异步操作(例如客户端到服务器的 FIDL 调用)之间的因果关系。flow.slice_out用于标识源客户端 slice,flow.slice_in用于标识处理 slice 的服务器。
内核计数器和功耗类别:
使用专用类别捕获的轨迹会在
kernel进程下发出计数器(例如kernel:power下的Rate:CPU:N,用于表示 CPU 频率缩放)。如需详细了解如何捕获和缩放 CPU 频率和带宽需求计数器,请参阅在轨迹中记录 CPU 频率。
常见的 Fuchsia PerfettoSQL 配方
1. 测量进程间的 FIDL IPC 延迟时间
Fuchsia 组件会发出流事件,以跟踪跨进程边界的 FIDL 调用。此查询可衡量从客户端请求调度 (slice_out) 到服务器执行开始 (slice_in) 的传输延迟时间,以及服务器执行时间:
SELECT
  client_proc.name AS client_process,
  server_proc.name AS server_process,
  slice_out.name AS client_operation,
  slice_in.name AS server_operation,
  ROUND((slice_in.ts - slice_out.ts) / 1e6, 3) AS transfer_latency_ms,
  ROUND(slice_in.dur / 1e6, 3) AS server_dur_ms
FROM flow
JOIN slice AS slice_out ON flow.slice_out = slice_out.id
JOIN slice AS slice_in ON flow.slice_in = slice_in.id
JOIN thread_track AS client_tt ON slice_out.track_id = client_tt.id
JOIN thread AS client_th ON client_tt.utid = client_th.utid
JOIN process AS client_proc ON client_th.upid = client_proc.upid
JOIN thread_track AS server_tt ON slice_in.track_id = server_tt.id
JOIN thread AS server_th ON server_tt.utid = server_th.utid
JOIN process AS server_proc ON server_th.upid = server_proc.upid
ORDER BY transfer_latency_ms DESC
LIMIT 20;
2. 组件中最耗时的操作
如需查找特定组件(例如 netstack.cm)中消耗总时间最多的操作,请执行以下操作:
SELECT
  slice.name AS operation,
  COUNT(*) AS count,
  ROUND(SUM(slice.dur) / 1e6, 3) AS total_dur_ms,
  ROUND(AVG(slice.dur) / 1e6, 3) AS avg_dur_ms,
  ROUND(MAX(slice.dur) / 1e6, 3) AS max_dur_ms
FROM slice
JOIN thread_track ON slice.track_id = thread_track.id
JOIN thread USING (utid)
JOIN process USING (upid)
WHERE process.name LIKE '%netstack%' AND slice.dur > 0
GROUP BY slice.name
ORDER BY total_dur_ms DESC
LIMIT 20;
3. 识别睡眠不安者(线程唤醒和抖动)
如果线程的上下文切换 / 唤醒次数很高,但平均运行时长非常短(例如 < 0.1 ms),则表示轮询抖动或计时器抖动:
SELECT
  t.name AS thread_name,
  t.tid AS tid,
  p.name AS process_name,
  COUNT(*) AS wakeup_count,
  ROUND(AVG(ts.dur) / 1e6, 3) AS avg_duration_ms,
  ROUND(SUM(ts.dur) / 1e6, 3) AS total_duration_ms
FROM thread_state ts
JOIN thread t USING (utid)
LEFT JOIN process p USING (upid)
WHERE ts.state = 'Running'
GROUP BY utid
ORDER BY wakeup_count DESC
LIMIT 20;
4. 每个线程的 CPU 执行时间(sched 表)
使用 kernel:sched 捕获轨迹时,sched 表会记录 CPU 量子持续时间:
SELECT
  process.name AS process_name,
  thread.name AS thread_name,
  COUNT(*) AS context_switches,
  ROUND(SUM(sched.dur) / 1e6, 3) AS total_cpu_time_ms,
  ROUND(AVG(sched.dur) / 1e3, 3) AS avg_quantum_us
FROM sched
JOIN thread USING (utid)
JOIN process USING (upid)
WHERE sched.dur > 0
GROUP BY process.name, thread.name
ORDER BY total_cpu_time_ms DESC
LIMIT 20;
5. 检查轨迹事件实参
如需查询附加到跟踪记录切片的键值对,请执行以下操作:
SELECT
  slice.name AS slice_name,
  args.key AS arg_name,
  COALESCE(
    args.string_value,
    CAST(args.int_value AS TEXT),
    CAST(args.real_value AS TEXT)
  ) AS arg_value
FROM slice
JOIN args ON slice.arg_set_id = args.arg_set_id
WHERE slice.name = 'ChannelMessage'
LIMIT 50;
6. 时间间隔重叠匹配
查询与特定时间窗口 [start_ts, end_ts] 重叠的切片或事件时,请使用重叠逻辑,而不是严格的包含逻辑,以捕获在窗口之前开始或在窗口之后结束的事件:
SELECT
  slice.name,
  slice.ts,
  slice.dur
FROM slice
WHERE (slice.ts + slice.dur) >= <START_TS>
  AND slice.ts <= <END_TS>;
跨工具和环境运行查询
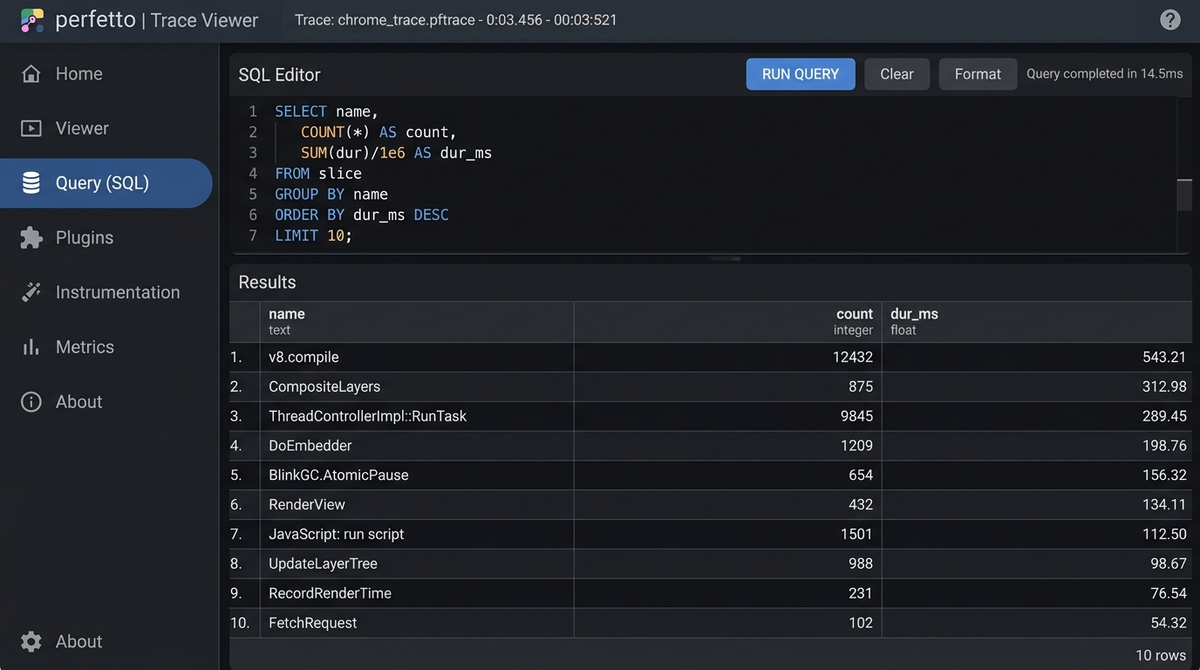
1. Perfetto 网页界面中的“查询”标签页
您可以在 Perfetto 界面中以交互方式运行 SQL 查询:
1. 在 https://ui.perfetto.dev 中打开 .fxt 文件。
2. 点击左侧边栏中的 Query (SQL)。
3. 输入查询内容,然后按 Ctrl+Enter 键(在 macOS 上按 Cmd+Enter 键)。
使用 HTTP RPC 模式检查大型轨迹
如果轨迹文件过大,无法在 Web 浏览器内存中顺利加载,您可以将 Trace Processor 在本地作为 HTTP RPC daemon 运行:
./prebuilt/third_party/perfetto/trace_processor_shell/linux-x64/trace_processor_shell \
  --httpd --http-port 9001 trace.fxt
运行后,前往 https://ui.perfetto.dev,然后在导航栏中选择 Open with HTTP RPC。
2. 独立轨迹处理器 Shell (trace_processor_shell)
trace_processor_shell 是由 Perfetto 上游开发的独立二进制引擎,可为 fx perf-analyze 和 Perfetto 的分析工具提供支持。
Fuchsia 源代码检出包含以下位置下的预构建二进制文件:
posix-terminal
prebuilt/third_party/perfetto/trace_processor_shell/<PLATFORM>/trace_processor_shell
其中 <PLATFORM> 为 linux-x64、linux-arm64。
如果您在 Fuchsia 代码库之外工作,可以直接从 Perfetto 下载二进制文件:
posix-terminal
curl -LO https://get.perfetto.dev/trace_processor
chmod +x ./trace_processor
交互式 REPL:
./prebuilt/third_party/perfetto/trace_processor_shell/linux-x64/trace_processor_shell \
  trace.fxt
使用
fx perf-analyze运行内嵌查询:fx perf-analyze query \ --trace trace.fxt \ --sql "SELECT count(*) AS total_slices FROM slice;"使用
fx perf-analyze运行批量查询文件:fx perf-analyze query \ --trace trace.fxt \ --batch @queries.json