
記錄 Fuchsia 追蹤記錄 (.fxt) 後,您可以使用 Perfetto 的追蹤記錄處理器引擎,透過 SQL 以程式輔助方式查詢及分析基礎追蹤記錄資料。Perfetto UI 提供互動式時間軸視覺化功能,而 SQL 分析則可自動偵測異常狀況、量化效能迴歸分析,以及批次指標彙整。
如要瞭解核心 PerfettoSQL 方言、查詢語法和標準資料表,請參閱官方的「PerfettoSQL 入門」和「Perfetto SQL 資料表」說明文件。
本指南說明如何使用下列工具分析 Fuchsia 追蹤記錄:
* 選擇合適的追蹤記錄分析工具
* 使用 fx perf-analyze 進行高階效能分類
* Fuchsia 追蹤記錄結構定義和資料模型
* 常見的 Fuchsia PerfettoSQL 食譜
* 跨工具和環境執行查詢
選擇合適的追蹤記錄分析工具
Fuchsia 開發人員主要有三種方式可查詢及檢查追蹤資料。選擇最符合工作流程的工具:
-
視覺化探索和臨時檢查:以互動方式瀏覽時間軸軌跡、檢查切片詳細資料、在瀏覽器中執行臨時 SQL 查詢,以及分享永久連結。
fx perf-analyze(建議 Fuchsia 使用)自動分類和指令碼分析:執行精選的診斷外掛程式 (
cpu、binder)、產生結構化輸出內容 (markdown、json、text),以及直接從主機終端機執行批次 SQL 查詢。這是代理互動和自動工作流程的首選介面。trace_processor_shell獨立和非 Fuchsia 環境:PerfettoSQL 背後的基礎引擎。在 Fuchsia 來源結帳以外的環境中開發時 (
fx無法使用),針對上游 Perfetto SDK 建構自訂 Python/C++ 自動化作業,或使用互動式終端機 REPL 時,請使用這個選項。
使用 fx perf-analyze 進行高階效能分類
對於常見的分類工作流程,您不需要從頭撰寫原始 SQL 查詢。Fuchsia 提供 fx perf-analyze,這項主機端 CLI 工具可將標準效能啟發式方法封裝至自動分析外掛程式,並提供彈性的查詢執行元件。
fx perf-analyze 支援本機 .fxt 檔案,以及 Perfetto UI 永久連結網址 (自動下載及快取追蹤記錄)。
自動分類外掛程式 (fx perf-analyze analyze)
analyze 子指令會執行專門的診斷外掛程式:
fx perf-analyze analyze --trace <TRACE_FILE_OR_URL> --plugin <PLUGIN_NAME>您可以選擇格式化的 Markdown 表格輸出 (--format markdown)、結構化 JSON (--format json) 或以 Tab 分隔的文字 (--format text)。
1. CPU 使用率和閒置電源分流 (cpu 外掛程式)
cpu 外掛程式會執行多維度診斷套件,稽核系統活動、過度喚醒和耗電阻斷器:
難以入睡的睡眠者 (喚醒次數):找出內容切換/喚醒頻率高且執行時間短的執行緒,找出導致 CPU 核心無法進入深層睡眠狀態的計時器抖動或未合併的輪詢迴圈。
每個核心的利用率和處理速率:評估核心工作週期 (非閒置的活動時間百分比),並根據 DVFS 頻率縮放計數器加權 (
Rate:CPU:N)。CPU 用量最高的執行緒 (常見問題):依 CPU 總累積執行時間排序執行緒。
非同步執行器負荷:評估 Fuchsia 非同步 Future 輪詢 (
executor/fuchsia_async) 所花費的時間。繫結器 IPC 細目:量化 Starnix/Android 繫結器 IPC 交易量和延遲時間。
暫停及喚醒租約追蹤:稽核系統活動管理員 (SAG) 暫停嘗試,以及防止系統暫停的有效喚醒租約。
fx perf-analyze --format markdown analyze \
  --trace trace.fxt \
  --plugin cpu \
  --limit 10
2. Starnix Binder 和 IPC 效能瓶頸分析 (binder 外掛程式)
binder 外掛程式會稽核 IPC 交易延遲和排程瓶頸:
錯過的喚醒:偵測排程延遲,其中執行緒可執行 (
R狀態),但等待時間過長才排定至 CPU。繫結器交易延遲:測量用戶端分派、佇列等待和伺服器處理的端對端流程延遲。
fx perf-analyze --format markdown analyze \
  --trace trace.fxt \
  --plugin binder \
  --threshold-ms 10.0
使用 fx perf-analyze query 執行自訂查詢和批次查詢
如要透過指令列執行臨時 SQL 查詢,請按照下列步驟操作:
fx perf-analyze --format markdown query \
  --trace trace.fxt \
  --sql "SELECT count(*) AS total_slices FROM slice"
如要在單一 Trace Processor 擷取工作階段中執行多項查詢 (避免重複的追蹤記錄剖析負擔),請使用 @filepath 傳遞 JSON 查詢批次:
[
  {
    "name": "total_slices",
    "sql": "SELECT count(*) AS count FROM slice;"
  },
  {
    "name": "unique_threads",
    "sql": "SELECT count(DISTINCT utid) AS count FROM thread;"
  }
]
fx perf-analyze --format json query \
  --trace trace.fxt \
  --batch @queries.json
Fuchsia 追蹤記錄結構定義和資料模型
Perfetto 追蹤記錄處理器擷取 Fuchsia 追蹤記錄 (.fxt) 時,會將二進位記錄剖析為關聯式 SQLite 資料表。如需完整的結構定義參考資料,請參閱「Perfetto SQL 資料表」。
Fuchsia 追蹤記錄的相關重要概念和 ID 關係包括:
單位:所有時間戳記 (
ts) 和時間長度值 (dur) 都會儲存為整數奈秒。將奈秒除以1e6即可轉換為毫秒 (例如dur / 1e6 AS dur_ms)。處理程序和執行緒:
process.name:Fuchsia 使用者空間程序會依元件網址/資訊清單名稱 (例如archivist.cm、netstack.cm、scenic.cm) 或核心程序名稱 (kernel) 識別。process.pid和thread.tid:比對 Fuchsia 核心物件 ID (KOID)。upid和utid:Trace Processor 產生的專屬內部 ID,用於區分 PID/TID 回收程序中的程序和執行緒。
軌和切片 (加入階層):
切片會與時間軸軌跡建立關聯,而非直接與執行緒建立關聯。
如要將
slice與thread和process建立關聯,請透過thread_track加入:
FROM slice s
JOIN thread_track tt ON s.track_id = tt.id
JOIN thread t USING (utid)
JOIN process p USING (upid)
流程 (跨程序 / 非同步因果關係):
flow表格會對應非同步作業之間的因果關係,例如用戶端到伺服器的 FIDL 呼叫。flow.slice_out用於識別原始用戶端切片,flow.slice_in則用於識別處理切片的伺服器。
核心計數器和電源類別:
使用特定類別擷取的追蹤記錄會在
kernel程序下發出計數器 (例如kernel:power下的 CPU 頻率縮放Rate:CPU:N)。如要瞭解如何擷取及縮放 CPU 頻率和頻寬需求計數器,請參閱「在追蹤記錄中記錄 CPU 頻率」。
常見的 Fuchsia PerfettoSQL 做法
1. 測量跨程序的 FIDL IPC 延遲時間
Fuchsia 元件會發出流程事件,追蹤跨程序界線的 FIDL 呼叫。這項查詢會測量從用戶端要求分派 (slice_out) 到伺服器執行開始 (slice_in) 的轉移延遲時間,以及伺服器執行時間:
SELECT
  client_proc.name AS client_process,
  server_proc.name AS server_process,
  slice_out.name AS client_operation,
  slice_in.name AS server_operation,
  ROUND((slice_in.ts - slice_out.ts) / 1e6, 3) AS transfer_latency_ms,
  ROUND(slice_in.dur / 1e6, 3) AS server_dur_ms
FROM flow
JOIN slice AS slice_out ON flow.slice_out = slice_out.id
JOIN slice AS slice_in ON flow.slice_in = slice_in.id
JOIN thread_track AS client_tt ON slice_out.track_id = client_tt.id
JOIN thread AS client_th ON client_tt.utid = client_th.utid
JOIN process AS client_proc ON client_th.upid = client_proc.upid
JOIN thread_track AS server_tt ON slice_in.track_id = server_tt.id
JOIN thread AS server_th ON server_tt.utid = server_th.utid
JOIN process AS server_proc ON server_th.upid = server_proc.upid
ORDER BY transfer_latency_ms DESC
LIMIT 20;
2. 元件中耗時最長的作業
如要找出特定元件 (例如 netstack.cm) 中耗用最多總時間的作業,請按照下列步驟操作:
SELECT
  slice.name AS operation,
  COUNT(*) AS count,
  ROUND(SUM(slice.dur) / 1e6, 3) AS total_dur_ms,
  ROUND(AVG(slice.dur) / 1e6, 3) AS avg_dur_ms,
  ROUND(MAX(slice.dur) / 1e6, 3) AS max_dur_ms
FROM slice
JOIN thread_track ON slice.track_id = thread_track.id
JOIN thread USING (utid)
JOIN process USING (upid)
WHERE process.name LIKE '%netstack%' AND slice.dur > 0
GROUP BY slice.name
ORDER BY total_dur_ms DESC
LIMIT 20;
3. 找出睡眠不安穩的裝置 (執行緒喚醒和流失)
如果執行緒的內容切換 / 喚醒次數很高,但平均執行時間很短 (例如 < 0.1 ms),表示輪詢流失或計時器抖動:
SELECT
  t.name AS thread_name,
  t.tid AS tid,
  p.name AS process_name,
  COUNT(*) AS wakeup_count,
  ROUND(AVG(ts.dur) / 1e6, 3) AS avg_duration_ms,
  ROUND(SUM(ts.dur) / 1e6, 3) AS total_duration_ms
FROM thread_state ts
JOIN thread t USING (utid)
LEFT JOIN process p USING (upid)
WHERE ts.state = 'Running'
GROUP BY utid
ORDER BY wakeup_count DESC
LIMIT 20;
4. 每個執行緒的 CPU 執行時間 (sched 表格)
使用 kernel:sched 擷取追蹤記錄時,「sched」表格會記錄 CPU 量子持續時間:
SELECT
  process.name AS process_name,
  thread.name AS thread_name,
  COUNT(*) AS context_switches,
  ROUND(SUM(sched.dur) / 1e6, 3) AS total_cpu_time_ms,
  ROUND(AVG(sched.dur) / 1e3, 3) AS avg_quantum_us
FROM sched
JOIN thread USING (utid)
JOIN process USING (upid)
WHERE sched.dur > 0
GROUP BY process.name, thread.name
ORDER BY total_cpu_time_ms DESC
LIMIT 20;
5. 檢查追蹤事件引數
如要查詢附加至追蹤記錄切片的鍵/值引數,請執行下列操作:
SELECT
  slice.name AS slice_name,
  args.key AS arg_name,
  COALESCE(
    args.string_value,
    CAST(args.int_value AS TEXT),
    CAST(args.real_value AS TEXT)
  ) AS arg_value
FROM slice
JOIN args ON slice.arg_set_id = args.arg_set_id
WHERE slice.name = 'ChannelMessage'
LIMIT 50;
6. 時間間隔重疊比對
查詢與特定時間範圍重疊的切片或事件時,請使用重疊邏輯,而非嚴格的包含邏輯,擷取在時間範圍之前開始或之後結束的事件:[start_ts, end_ts]
SELECT
  slice.name,
  slice.ts,
  slice.dur
FROM slice
WHERE (slice.ts + slice.dur) >= <START_TS>
  AND slice.ts <= <END_TS>;
跨工具和環境執行查詢
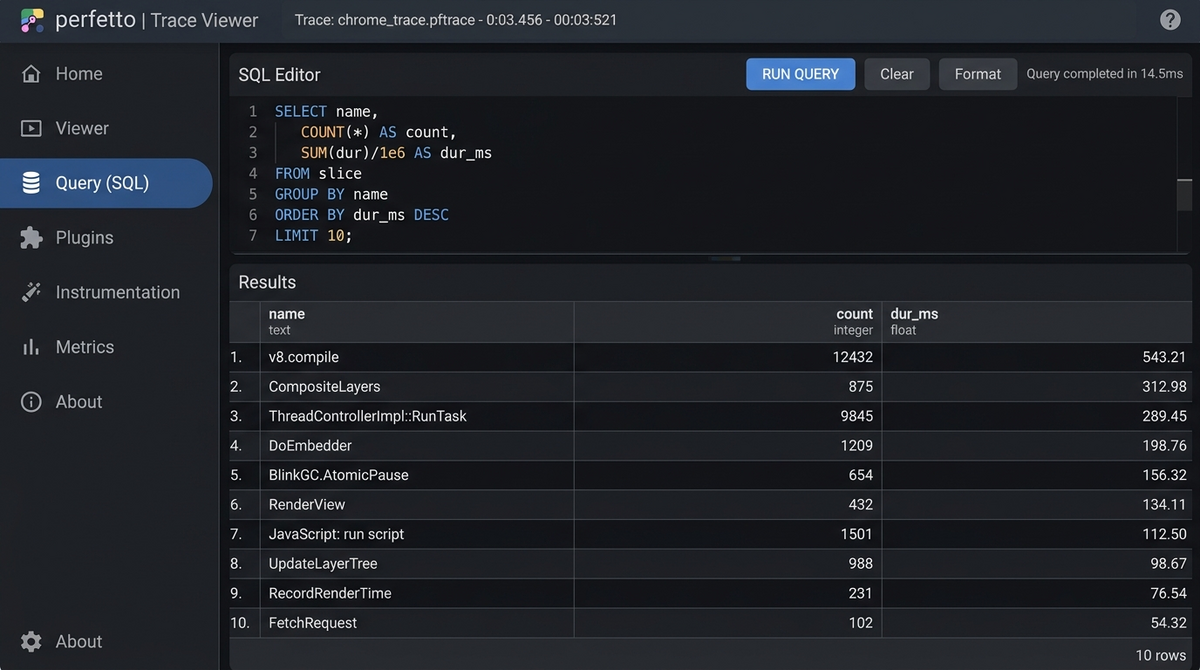
1. Perfetto 網頁 UI 的「Query」分頁
您可以在 Perfetto UI 中以互動方式執行 SQL 查詢:
1. 在 https://ui.perfetto.dev 中開啟 .fxt 檔案。
2. 按一下左側邊欄中的「查詢 (SQL)」。
3. 輸入查詢內容,然後按下 Ctrl+Enter 鍵 (或 macOS 上的 Cmd+Enter 鍵)。
使用 HTTP RPC 模式檢查大型追蹤記錄
如果追蹤記錄檔過大,無法在網路瀏覽器記憶體中順暢載入,您可以在本機以 HTTP RPC Daemon 的形式執行 Trace Processor:
./prebuilt/third_party/perfetto/trace_processor_shell/linux-x64/trace_processor_shell \
  --httpd --http-port 9001 trace.fxt
執行後,請前往 https://ui.perfetto.dev,然後在導覽列中選取「Open with HTTP RPC」。
2. 獨立的追蹤記錄處理器 Shell (trace_processor_shell)
trace_processor_shell 是 Perfetto 上游開發的獨立二進位引擎,可為 fx perf-analyze 和 Perfetto 的分析工具提供支援。
Fuchsia 來源結帳作業包括以下位置的預先建構二進位檔:
posix-terminal
prebuilt/third_party/perfetto/trace_processor_shell/<PLATFORM>/trace_processor_shell
其中 <PLATFORM> 是 linux-x64、linux-arm64。
如果您在 Fuchsia 結帳程序以外工作,可以直接從 Perfetto 下載二進位檔:
posix-terminal
curl -LO https://get.perfetto.dev/trace_processor
chmod +x ./trace_processor
互動式 REPL:
./prebuilt/third_party/perfetto/trace_processor_shell/linux-x64/trace_processor_shell \
  trace.fxt
使用
fx perf-analyze執行內嵌查詢:fx perf-analyze query \ --trace trace.fxt \ --sql "SELECT count(*) AS total_slices FROM slice;"使用
fx perf-analyze執行批次查詢檔案:fx perf-analyze query \ --trace trace.fxt \ --batch @queries.json